MARD 재고수량 - ECC와 S/4HANA는 어떻게 다른가
같은 SELECT, 다른 동작
ECC에서도 S/4HANA에서도 이 코드는 그대로 동작하고, LABST(가용재고) 같은 수량 필드에 값이 들어옵니다. 코드만 보면 아무것도 달라지지 않은 것처럼 보입니다.
그런데 그 값이 만들어지는 방식이 완전히 다릅니다. 한쪽은 이미 저장된 값을 읽는 것이고, 다른 쪽은 읽는 순간 계산하는 것입니다.
자재문서를 전기할 때마다 MARD의 수량 필드를 직접 UPDATE해서 누적합니다. 조회는 저장된 숫자를 그대로 읽어옵니다.
수량을 어디에도 누적해 두지 않습니다. 조회 시점에 자재문서를 집계해서 그때그때 만들어 냅니다.
ECC - 집계 테이블 방식
ECC는 디스크 기반 데이터베이스를 전제로 설계됐습니다. 수백만 건의 자재문서를 매번 더하는 건 너무 느리니, 미리 더해 둔 결과를 따로 저장하는 방식을 택했습니다. 이런 테이블을 집계 테이블이라고 부릅니다.
| 테이블 | 보관하는 재고 |
|---|---|
MARD | 저장위치별 재고 |
MARC | 플랜트별 재고 |
MCHB | 배치별 재고 |
MSKA | 판매오더 재고 |
MSLB | 특별재고(외주 등) |
대가가 있습니다. 전기할 때마다 같은 행을 UPDATE하므로 같은 자재에 동시 전기가 몰리면 잠금 경합이 생깁니다. 월말에 입출고가 집중되면 체감되는 부분입니다.
S/4HANA - 그 테이블을 없앴다
S/4HANA는 인메모리 DB를 전제로 하기 때문에, 읽을 때 더해도 충분히 빠르다는 판단에서 설계가 바뀌었습니다.
- 자재문서는
MKPF+MSEG가 아니라MATDOC한 테이블에 헤더와 품목이 함께 들어갑니다. - 집계 테이블의 수량 필드는 더 이상 갱신되지 않습니다.
- 대신 조회 시점에 자재문서를 집계해 수량을 만듭니다.
자재문서 테이블 통합(MKPF·MSEG → MATDOC)은 S/4HANA 기본 (구매 관점) 글에서도 다뤘습니다. 이 글은 그중 재고수량이 어떻게 조회되는지를 파고듭니다.
SELECT * FROM MARD 는 실제로 무엇을 거치나
여기가 이 글의 핵심입니다. 코드는 MARD를 읽는다고 썼지만, 실제로는 여러 단계를 거칩니다.
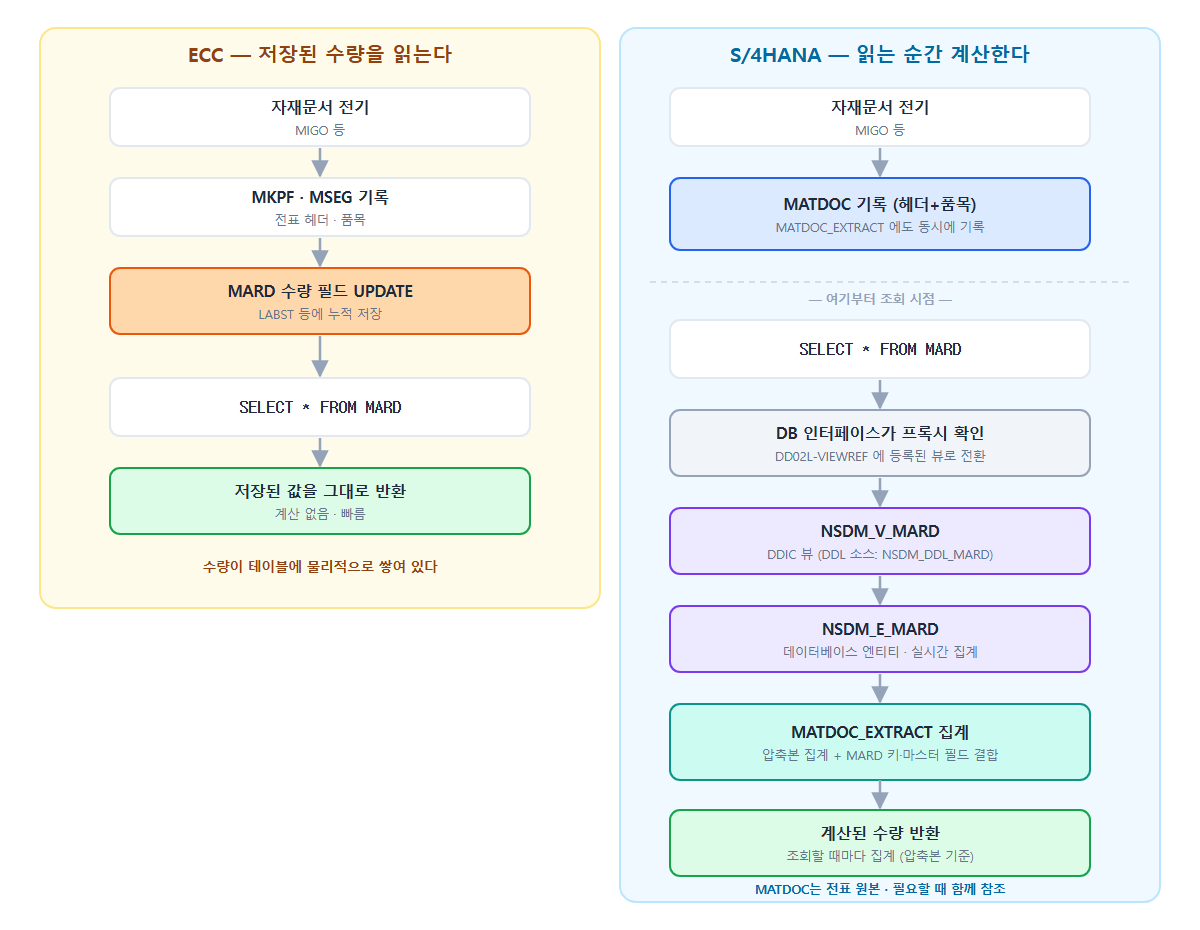
단계별로 보면 이렇습니다.
| 단계 | 무슨 일이 일어나나 |
|---|---|
| 1. ABAP SQL 실행 | 개발자는 MARD를 읽는다고 작성 |
| 2. 프록시 확인 | DB 인터페이스가 이 테이블에 대체 뷰가 등록돼 있는지 확인하고 그쪽으로 전환 |
3. NSDM_V_MARD | MARD를 대신하는 DDIC 뷰. DDL 소스는 NSDM_DDL_MARD |
4. NSDM_E_MARD | 데이터베이스 레벨 엔티티. 여기서 실시간 집계가 일어남 |
5. MATDOC_EXTRACT 집계 | 자재문서를 압축해 둔 테이블을 더해 수량을 산출 |
6. MARD 물리 테이블 결합 | 키와 마스터 성격 필드는 원래 테이블에서 가져와 합침 |
| 7. 결과 반환 | 계산된 수량이 담긴 결과가 돌아옴 |
MATDOC과 MATDOC_EXTRACT의 역할 차이
둘 다 자재문서와 관련되지만 쓰임이 다릅니다.
자재문서의 헤더와 품목이 모두 들어 있는 원본 데이터입니다. 전표 내역을 봐야 할 때 참조합니다.
수량 계산에 필요한 정보만 추린 압축 사본입니다. MATDOC에 기록될 때 함께 기록되며, 재고 집계를 빠르게 하려고 존재합니다.
그럼 매번 전부 다 더하는 걸까
가장 많이 나오는 질문입니다. 집계는 조회할 때마다 일어나는 것이 맞습니다. 수량을 어디에도 저장해 두지 않으니 읽을 때 계산하는 수밖에 없습니다.
다만 전표 전체를 매번 훑는 것은 아닙니다. 그러면 몇 년 치가 쌓인 시스템에서 버틸 수가 없습니다. 여기서 사전 압축(pre-compacting) 이 역할을 합니다.
압축 처리가 돌면 같은 재고 키·같은 기간의 움직임이 한 레코드로 합쳐집니다. 그 기간의 증감분만 남습니다.
아직 마감되지 않았으므로 개별 움직임이 그대로 남아 있습니다.
그래서 실제로 더해지는 양은 "지난 기간들의 압축된 줄 + 이번 기간의 움직임" 정도입니다. 자재 하나를 조회하면 수만 건이 아니라 수십~수백 건 수준을 더하는 셈이라, 인메모리에서는 충분히 빠릅니다.
압축은 언제 도나
"기간이 끝나야 압축된다"고 오해하기 쉬운데, 정확히는 기간 마감이 마지노선입니다.
| 시점 | 내용 |
|---|---|
| 자동 (늦어도) | 기간 마감 처리(MMPV) 때 반드시 실행 |
| 수동 · 임의 | 기간 중에 아무 때나, 여러 번 실행 가능 |
수동 실행에 쓰는 리포트는 NSDM_MTDCSA_PRECOMP 입니다. 전표가 빠르게 쌓이는 시스템이라면 기간 마감을 기다리지 말고 주기적으로 돌리는 편이 조회 성능 유지에 유리합니다.
압축을 해도 시간이 지나면 느려집니다. 기간이 쌓일수록 압축된 줄 자체가 늘어나기 때문입니다. 그래서 압축 위에 아카이빙과 정리(purging)라는 층이 더 있습니다. 바로 다음 절에서 다룹니다.
데이터가 쌓이면 - 운영 관점 처리 방안
MATDOC은 모든 자재 이동이 쌓이는 테이블이라, 운영이 길어지면 반드시 커집니다. SAP은 이를 네 개의 층으로 다룹니다. 아래로 갈수록 효과가 크지만 되돌리기 어렵습니다.
① 사전 압축 - 가장 먼저, 가장 자주
앞에서 본 그대로입니다. NSDM_MTDCSA_PRECOMP 를 주기적으로 돌립니다.
- 전표가 사라지지 않으므로 업무 영향이 없습니다.
- 기간 중에도 여러 번 돌릴 수 있습니다.
- 가장 먼저 검토할 카드입니다. 이것만으로 해결되는 경우가 꽤 있습니다.
② 아카이빙 - 전표를 밖으로 빼되, 재고는 지킨다
자재문서 아카이빙 오브젝트는 MM_MATBEL 입니다. 여기서 중요한 설계가 하나 있습니다.
아카이빙한다고 해서 전표가 그냥 삭제되지는 않습니다. 삭제 시점에 시스템이 아카이브 대표 레코드를 만들어 둡니다. 전표 품목 하나가 대표 레코드 하나로 1:1 대응되고, 문서 관련 정보는 빠지고 재고 계산에 필요한 정보만 남습니다. 그래야 재고 수량이 계속 맞기 때문입니다.
이 대표 레코드가 ARC_DELTA 유형입니다. 즉 아카이빙은 "데이터를 없애는 것"이 아니라 "전표 상세를 빼고 재고 기여분만 남기는 것" 에 가깝습니다.
업무 영향은 있습니다. 아카이빙된 전표는 평소 조회 화면에서 바로 보이지 않습니다. 보존 기간과 조회 요건을 업무·회계 쪽과 합의한 뒤에 진행해야 합니다.
③ 정리(Purging) - 과거 기간을 합쳐 없앤다
압축이 "기간 안에서 합치기"라면, 정리는 "여러 기간을 하나로 합쳐 과거를 없애기" 입니다.
- 여러 기간에 걸친
ARC_DELTA레코드를 모아PURGE_CF유형 하나로 대체합니다. - 그 결과 정리 기준 기간보다 오래된 데이터는 DB에서 사라집니다.
- 실행 프로그램은
NSDM_MATDOC_PURGE_RUN이고, 회사코드·플랜트·자재 단위로 범위를 지정할 수 있습니다.
정리는 되돌릴 수 없습니다. 과거 기간의 재고 추이를 조회해야 하는 요건이 있다면 그 기간은 건드리면 안 됩니다. 반드시 아카이빙을 먼저 하고, 보존 정책을 확정한 뒤에 적용하세요.
④ 파티셔닝 - 한계에 닿기 전에
이건 데이터를 줄이는 게 아니라 담는 그릇을 나누는 이야기입니다.
HANA 컬럼 스토어 테이블은 파티션 하나당 약 20억 행 제한이 있습니다. MATDOC은 대형 사이트에서 이 선에 닿을 수 있는 몇 안 되는 테이블입니다.
- 파티션당 수억 건 수준으로 유지하는 것이 일반적인 권고입니다.
- 한계에 닿은 뒤에는 늦습니다. 재파티셔닝은 시간과 자원이 많이 들기 때문에, 여유가 있을 때 미리 계획해야 합니다.
- 이 작업은 Basis·DBA 영역입니다. 개발자가 단독으로 판단할 사안이 아닙니다.
어떤 순서로 접근할까
- 현황 측정 — 얼마나 쌓였고 얼마나 빨리 느는지
- 사전 압축 주기화 — 부작용 없는 카드부터
- 커스텀 코드 점검 — 전건 조회가 범인인 경우가 흔함
- 보존 정책 합의 → 아카이빙
- 필요 시 정리, 그리고 파티셔닝 계획
- 느리다고 바로 정리부터 돌리기
- 보존 요건 확인 없이 아카이빙
- 코드는 그대로 둔 채 데이터만 줄이기
- 20억 행에 닿은 뒤에 파티셔닝 검토
세 번째 항목을 특히 강조하고 싶습니다. 조회가 느린 진짜 원인이 데이터량이 아니라 코드인 경우가 많습니다. 조건 없이 MARD를 긁거나 루프 안에서 반복 조회하는 패턴이 있으면, 데이터를 아무리 줄여도 체감이 바뀌지 않습니다. 이 부분은 ABAP SQL 튜닝 시리즈를 참고하세요.
MARD 테이블이 사라진 건 아니다
자주 생기는 오해입니다. MARD 테이블은 그대로 있습니다.
- 키(플랜트·저장위치·자재)와 마스터 성격 필드는 그대로 유지됩니다.
- 다만 수량 컬럼을 아무도 갱신하지 않습니다.
그래서 조회 결과는 "물리 테이블의 마스터 필드 + 계산된 수량" 을 합친 모습이 됩니다.
개발자가 조심할 것
① ABAP SQL은 되고, 우회 경로는 0이 나온다
가장 많이 터지는 지점입니다.
SELECT ... FROM mard는 대체 뷰로 전환되므로 수량이 제대로 나옵니다.
ADBC, AMDP의 직접 테이블 참조, DB 툴 조회, 복제 솔루션 등 DB에 바로 붙는 경로는 물리 테이블을 읽습니다. 수량이 0 또는 과거 값으로 나옵니다.
"MARD의 LABST가 0으로 나온다"는 문의 대부분이 이 경우입니다. 테이블이 비어 보이는 게 아니라, 수량 컬럼만 갱신이 멈춘 상태라고 이해하면 됩니다.
외부 시스템 인터페이스나 데이터 복제를 설계할 때 특히 주의해야 합니다. MARD를 테이블 단위로 그대로 복제하면 재고수량이 맞지 않습니다. 재고가 필요하면 표준 CDS 뷰나 API를 거쳐 가져오세요.
② 수량 필드에 쓰지 마라
커스텀 프로그램에서 MARD의 수량 필드를 직접 UPDATE하는 코드가 있다면 제거해야 합니다. 물리 테이블에는 써지지만 조회 결과에는 반영되지 않아, 데이터만 어긋납니다. 재고 변동은 자재문서 전기로만 일어나야 합니다.
③ 대량 조회는 비용 구조가 다르다
ECC에서는 MARD 조회가 단순 읽기였지만, S/4HANA에서는 읽을 때마다 집계가 일어납니다. 앞에서 본 것처럼 사전 압축 덕분에 한 건당 더하는 양은 많지 않지만, 건수가 곱해지면 이야기가 달라집니다.
- 키를 특정해 소량 조회하면 체감 차이가 거의 없습니다.
- 조건 없이 대량으로 긁으면 집계 비용이 그대로 들어옵니다.
조회 조건을 좁히고 필요한 필드만 가져오는 기본기가 더 중요해집니다. 이 부분은 ABAP SQL 튜닝 시리즈와 그대로 이어집니다.
④ ATC가 프록시 경고를 띄운다
코드 점검을 돌리면 "이 테이블에는 대체(프록시) 뷰가 있다" 는 취지의 지적이 나옵니다. 오류라기보다 "이 테이블은 예전과 동작이 다르니 확인하라" 는 신호로 받아들이면 됩니다.
정리
| ECC | S/4HANA | |
|---|---|---|
| 수량 저장 | MARD 등 집계 테이블에 누적 저장 | 저장하지 않음 |
| 자재문서 | MKPF + MSEG | MATDOC |
| 조회 방식 | 저장된 값 읽기 | 조회 시점에 집계 |
| 조회 경로 | MARD 직접 | NSDM_V_MARD → NSDM_E_MARD → MATDOC_EXTRACT |
| 전기 시 잠금 경합 | 집계 행 UPDATE로 발생 가능 | 집계 행이 없어 완화 |
| 네이티브 SQL 조회 | 정상 | 수량 0 |
핵심은 두 가지입니다. ABAP SQL로 읽으면 예전처럼 동작한다는 것, 그리고 DB에 직접 붙는 모든 경로는 더 이상 믿을 수 없다는 것입니다.
뷰 이름과 스택 구성은 릴리스·SP에 따라 다를 수 있습니다. 자사 시스템에서는 SE11로 MARD를 열어 대체 뷰가 무엇으로 등록돼 있는지 직접 확인하시길 권합니다.
참고 자료
- New Simplified Data Model (NSDM) for Inventory Management Tables — SAP Help
- SAP S/4HANA: Inventory Management Tables New Simplified Data Model (NSDM) — SAP 작성 블로그
- Purging and Precompacting of Material Document Data — SAP Help
- Archiving Material Documents (MM-IM) — SAP Help
Disclaimer — 이 포스트는 AI(Claude)를 활용하여 작성된 초안을 바탕으로 검수 및 보완하여 작성되었습니다. 내용 중 오류나 오타가 있다면 댓글로 알려주시면 감사하겠습니다.